帖子
- 最上川2026-09-01
- popyui2026-09-01
- 最上川2026-09-01
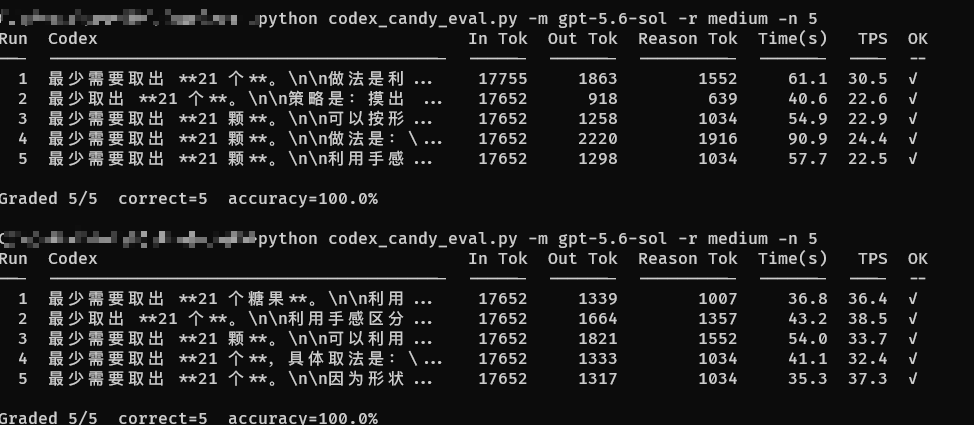
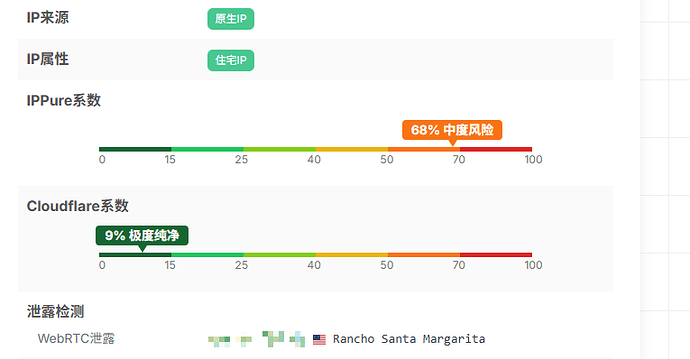
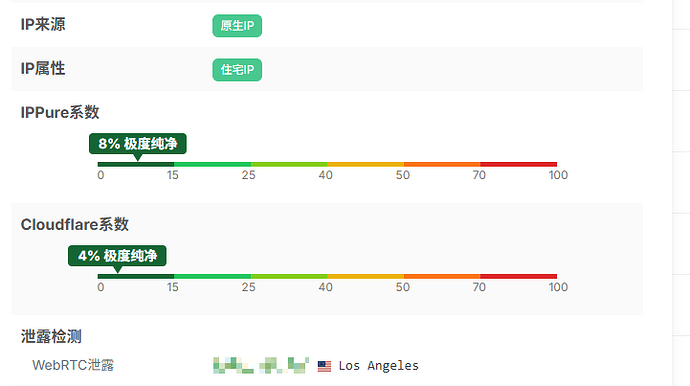
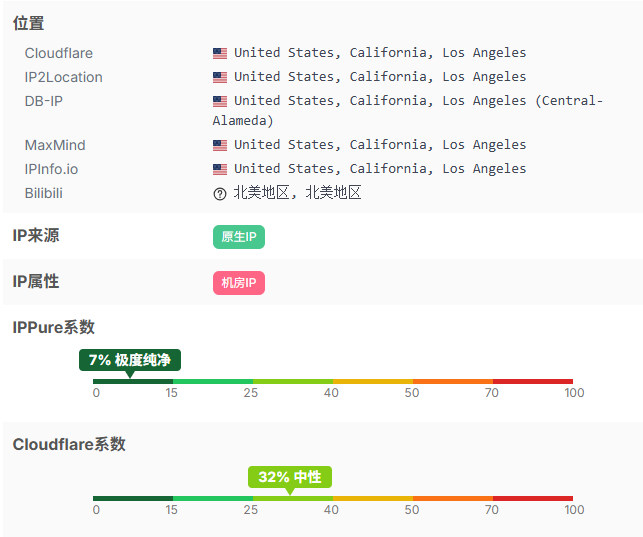
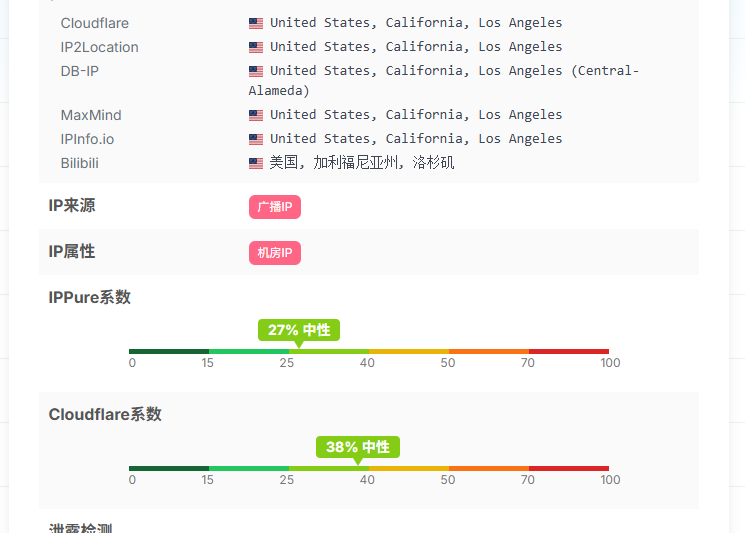
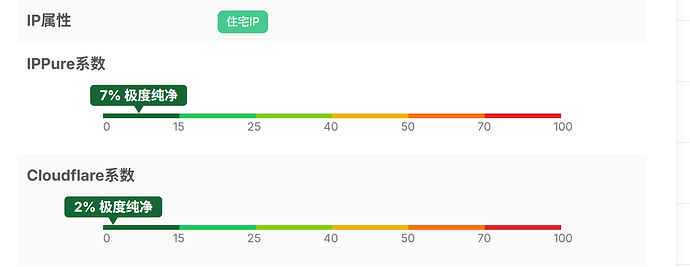
^-^会是地区的问题喵?洛杉矶高人一等的嘛?
- leonfox282026-09-01
openai的数据中心在哪?是不是单纯的离得近?
- 0xqaxwm2026-09-01
- 最上川2026-09-01
^-^一般来说服务器响应延迟不是按毫秒算的喵
- leonfox282026-09-01
看计算方法吧,如果首token延迟也被计算在tps里,那你本地机器->代理->openai的服务器延迟就挺重要了,尤其是你用脚本测试,应该没开ws,sse连接时每次消息来回应该都会走一次握手。假如首token延迟增加了1s并且这个测试有十轮思考或者工具调用,那就相当于总时间增加了10s
- Hao-linuxdo2026-09-01
sse连接时每次消息来回应该都会走一次握手。假如首token延迟增加了1s并且这个测试有十轮思考或者工具调用,那就相当于总时间增加了10s
并非你说的这样,一次完整的流式响应只需要建立一次 http 连接
- leonfox282026-09-01
不是的,以工具调用为例,每次工具调用完成返回结果,这就是一次SSE连接结束。最简单的你可以接一个cpa或者sub2api,看请求记录里几次工具调用就是几次连接