帖子
- dataflow2026-10-24
- af143c2026-10-24
- An2026-10-24
- Kami9582026-10-24
我之前用,缓存命中率好像不太好看?后面换observational-memory感觉还不错
- hermess2026-10-24
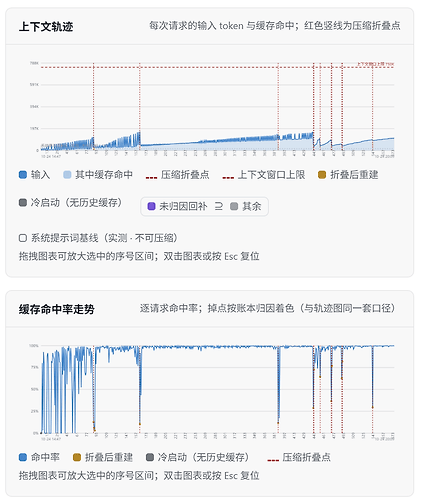
我是从opencode v1时代的acp用过来的,再到opencode v2环境下的billion context,主要是在公司环境下opencode里面使用,模型用的内网0731版本的ds v4 flash残血128K上下文版,实测差不多2个多月下来对于较小上下文的模型还是有一定作用。就像作者原文里面写的会对缓存命中率有一定影响,平均用下来大概在90%左右,接近作者测试的结果。
然后在我的coding的使用场景下偶尔在某些极端情况下会出现反复压缩失败然后爆上下文的情况。
相比较pi或者opencode原生的上下文管理优势来说就是长任务或者长session里面压缩之后agent执行不会偏移太多。坏处就是你重新看你的上下文里会发现里面思维链里面夹杂一堆扔给模型思考这里那里该不该压缩该不该蒸馏的东西,对模型角度来讲注意力机制可能会有偏移。但是现在模型普遍能力比较强,在我看来这点开销是有一定价值的。
 GaussPrime2026-10-24
dsh里用着还不错,就是缓存率会在95-96左右,但是上下文长度基本控制在10万以内,哪怕已经几亿的总消耗了
- Kassdin2026-10-24
直观看来大概率没什么用,billion context 自己那篇预印本里的评测做的都很水
- b1ElUd@mf2Kv52026-10-24
这样看token节省了,但是缓存率低了,费用会不会其实没有节省?